
Cómo traducir un vídeo (audio y subtítulos) con Claude Code o Codex
Utilizo principalmente la IA para mis proyectos de traducción. En YouTube, TikTok o Facebook hay muchos vídeos en chino que no ofrecen subtítulos automáticos ni traducción automática.
Como quiero entenderlos, he creado un proyecto capaz de automatizar gran parte del proceso: transcribir el vídeo, traducir los subtítulos y, si hace falta, llegar hasta el doblaje automático en francés.
A partir de esta misma base, también es posible crear automáticamente clippings, es decir, extractos cortos del vídeo.
En este artículo, tomo como ejemplo la traducción chino → francés. Pero el principio puede adaptarse a prácticamente todos los idiomas. Os animo encarecidamente a usar Claude Code o Codex CLI – en línea de comandos.
¿Por qué usar la transcripción en lugar del OCR?
Los vídeos chinos suelen tener subtítulos en chino directamente incrustados en la imagen. Por lo tanto, se podría usar OCR (reconocimiento de texto en una imagen) para recuperar esos subtítulos.
Después de varios intentos, sin embargo, me di cuenta de que este método era bastante largo y complicado. Al final es más sencillo partir directamente de la palabra presente en el vídeo y transformarla en texto gracias a un sistema de transcripción automática, llamado ASR (Automatic Speech Recognition).
El principio es, pues, bastante simple:
Vídeo → transcripción china → corrección → traducción francesa → subtítulos franceses → posiblemente doblaje
Preparar el skill
Para automatizar este proceso, recomiendo preparar de antemano algunos archivos de referencia en el skill. Contienen las reglas que los agentes deben respetar. Esto permite modificar fácilmente el comportamiento del sistema sin tener que reescribir todo el workflow.
references/
├── translation_rules.md   # reglas de traducción
├── glossary_zh_fr.md      # nombres propios y términos recurrentes
├── formatting_rules.md    # reglas de visualización de los subtítulos
└── quality_check.md       # controles de calidad
Estos archivos pueden prepararse con la ayuda de la IA. Simplemente aconsejo pedirle que proponga varias variantes o algunos ejemplos de traducción, y luego elegir el tono y las reglas que os convengan.
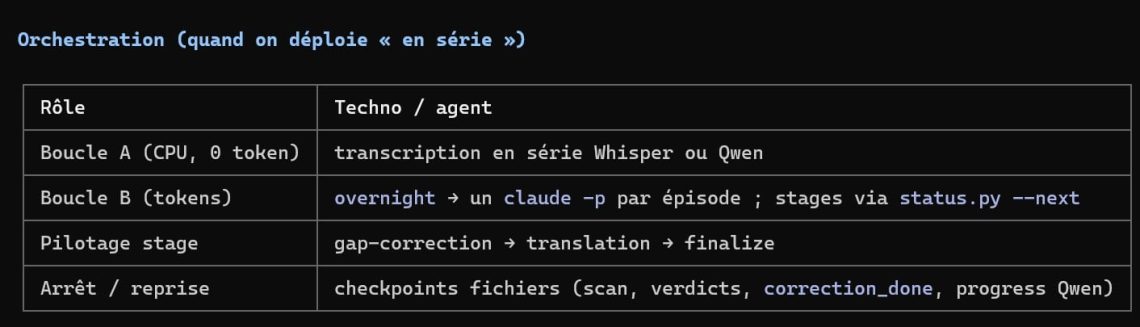
Para evitar sobrecargar la sesión principal con el texto de todo el vídeo, el workflow puede después utilizar agentes autónomos. Cada agente solo recibe la información y los archivos de referencia que necesita. Por ejemplo, un agente puede encargarse de la transcripción, otro de la traducción y otro del control de calidad. La sesión principal sirve sobre todo para orquestar las diferentes etapas.
El proceso completo
1. Transformar el habla china en subtítulos
Se empieza por recuperar el vídeo original. Para YouTube, Facebook o TikTok, se puede usar yt-dlp.
Luego se utiliza un sistema de reconocimiento de voz (ASR) para transformar el habla china en texto. El resultado es un archivo de subtítulos .srt que contiene el texto chino y los horarios de inicio y fin de cada segmento.
Se puede utilizar, entre otros:
- faster-whisper (medium)
- Qwen3-ASR ForcedAligner
Para el chino, prefiero Qwen3-ASR. Permite, entre otras cosas, aportar contexto antes de la transcripción, lo que puede ayudar al modelo a elegir el carácter correcto cuando varias palabras se pronuncian de la misma manera.
Si luego piensas hacer doblaje o clippings, activa también elmarcado temporal a nivel de palabra. Así tendrás una alineación mucho más precisa entre el texto y la voz.
2. Recuperar los fragmentos que no se han transcrito
Una transcripción automática no siempre es perfecta. La presencia de música, por ejemplo, puede interferir en el ASR. El sistema puede a veces considerar un fragmento como música o canto y no transcribir correctamente el habla.
Para localizar estos problemas, se pueden buscar en el archivo SRT los huecos anormalmente largos entre dos subtítulos.
Para cada fragmento que falta:
- se recupera el fragmento correspondiente con ffmpeg ;
- se vuelve a escuchar;
- se relanza una transcripción únicamente sobre ese fragmento.
Esto permite completar la transcripción sin tener que reprocesar todo el vídeo.
3. Corregir la transcripción china
El ASR puede cometer errores, sobre todo con los homófonos : el modelo reconoce correctamente el sonido, pero elige el carácter o la palabra china equivocada.
Por lo tanto, se releen los fragmentos sospechosos y se corrige la transcripción antes de empezar la traducción.
Una mala transcripción suele dar lugar a una mala traducción. Por eso, esta etapa merece una atención especial.
4. Traducir el chino al francés
Una vez corregida la transcripción china, se divide en segmentos. Los segmentos son tratados después por un agente autónomo especializado en la traducción.
El agente consulta, en particular, los archivos de referencia del skill para respetar las reglas definidas de antemano:
- nivel de lengua y registro;
- francés natural en lugar de traducción palabra por palabra;
- traducción de los nombres propios;
- términos recurrentes del glosario;
- reglas específicas para los diálogos.
Las traducciones se ensamblan después conservando los marcados temporales del archivo chino. Para los vídeos largos, es preferible trabajar un segmento a la vez. Los agentes autónomos pueden así procesar el texto sin saturar el contexto de la sesión principal.
5. Verificar y limpiar la traducción
Una vez terminada la traducción, se realizan varios controles automáticos:
- no debe quedar ningún carácter chino en el archivo francés;
- el formato SRT debe ser válido;
- los horarios deben ser coherentes;
- el registro debe mantenerse homogéneo;
- la traducción debe ser coherente de principio a fin.
Otro agente puede realizar después una revisión crítica chino ↔ francés. Su función es detectar los contrasentidos, las omisiones y las traducciones que cambian el sentido original. Esta verificación resulta especialmente útil cuando la traducción se ha hecho segmento por segmento: permite asegurarse de que el conjunto sigue siendo coherente.
Por último, se preparan los subtítulos para su visualización en pantalla:
- se divide el texto en puntos naturales;
- se reparte el texto en una o dos líneas;
- se comprueba la longitud y la legibilidad;
- se asegura que no se ha perdido ninguna palabra.
El archivo chino original se conserva como referencia para poder comparar las dos versiones.
6. El resultado final
El resultado principal es un archivo:
video.fr.srt
Contiene los subtítulos en francés con sus horarios.
A partir de este archivo, se puede después:
- incrustar los subtítulos en francés en el vídeo con ffmpeg;
- generar una versión doblada al francés (text-to-speech, con las voces gratuitas de Edge o Mac);
- crear automáticamente clippings o extractos de vídeo a partir de los subtítulos y sus timestamps.
En resumen
El flujo de trabajo completo puede resumirse así:
Vídeo chino → transcripción → corrección → traducción → control de calidad → subtítulos en francés → doblaje / clippings
El interés de esta organización es separar claramente las distintas tareas y dejar que los agentes autónomos procesen las partes más voluminosas. La sesión principal se mantiene así ligera y se centra en la orquestación del flujo de trabajo.
